Một AI agent dùng MCP lấy dữ liệu từ hồ sơ, cơ sở dữ liệu, công cụ tìm kiếm và tài liệu chính sách rồi ghép thành một câu trả lời. Mệnh đề trong câu trả lời đúng không đồng nghĩa với việc nguồn được dẫn cũng đúng. Bài viết của nhóm Multiverse Computing trên Hugging Face giới thiệu ProvenanceGuard, một lớp kiểm tra giữ lại danh tính nguồn của từng đầu ra MCP, đối chiếu từng mệnh đề với nguồn riêng và phát hiện lỗi gán nhầm nguồn.
Cách tiếp cận này bổ sung cho các điểm số kiểm tra tính trung thành của RAG, nhưng không phải chứng nhận rằng nội dung gốc luôn đúng. Kết quả nghiên cứu hiện đến từ một cấu hình thử nghiệm cụ thể, nên đội ngũ triển khai vẫn phải kiểm tra bằng dữ liệu, trace và quy trình duyệt của mình.
Khi nào câu trả lời đúng vẫn dẫn sai nguồn?
Một sự thật xuất hiện trong tài liệu này nhưng câu trả lời lại ghi công cho tài liệu khác. Nếu hệ thống gộp toàn bộ đầu ra công cụ thành một ngữ cảnh, bộ kiểm tra chỉ cần tìm thấy đoạn văn hỗ trợ ở bất kỳ đâu. Cách đó dễ bỏ qua lỗi nguồn.
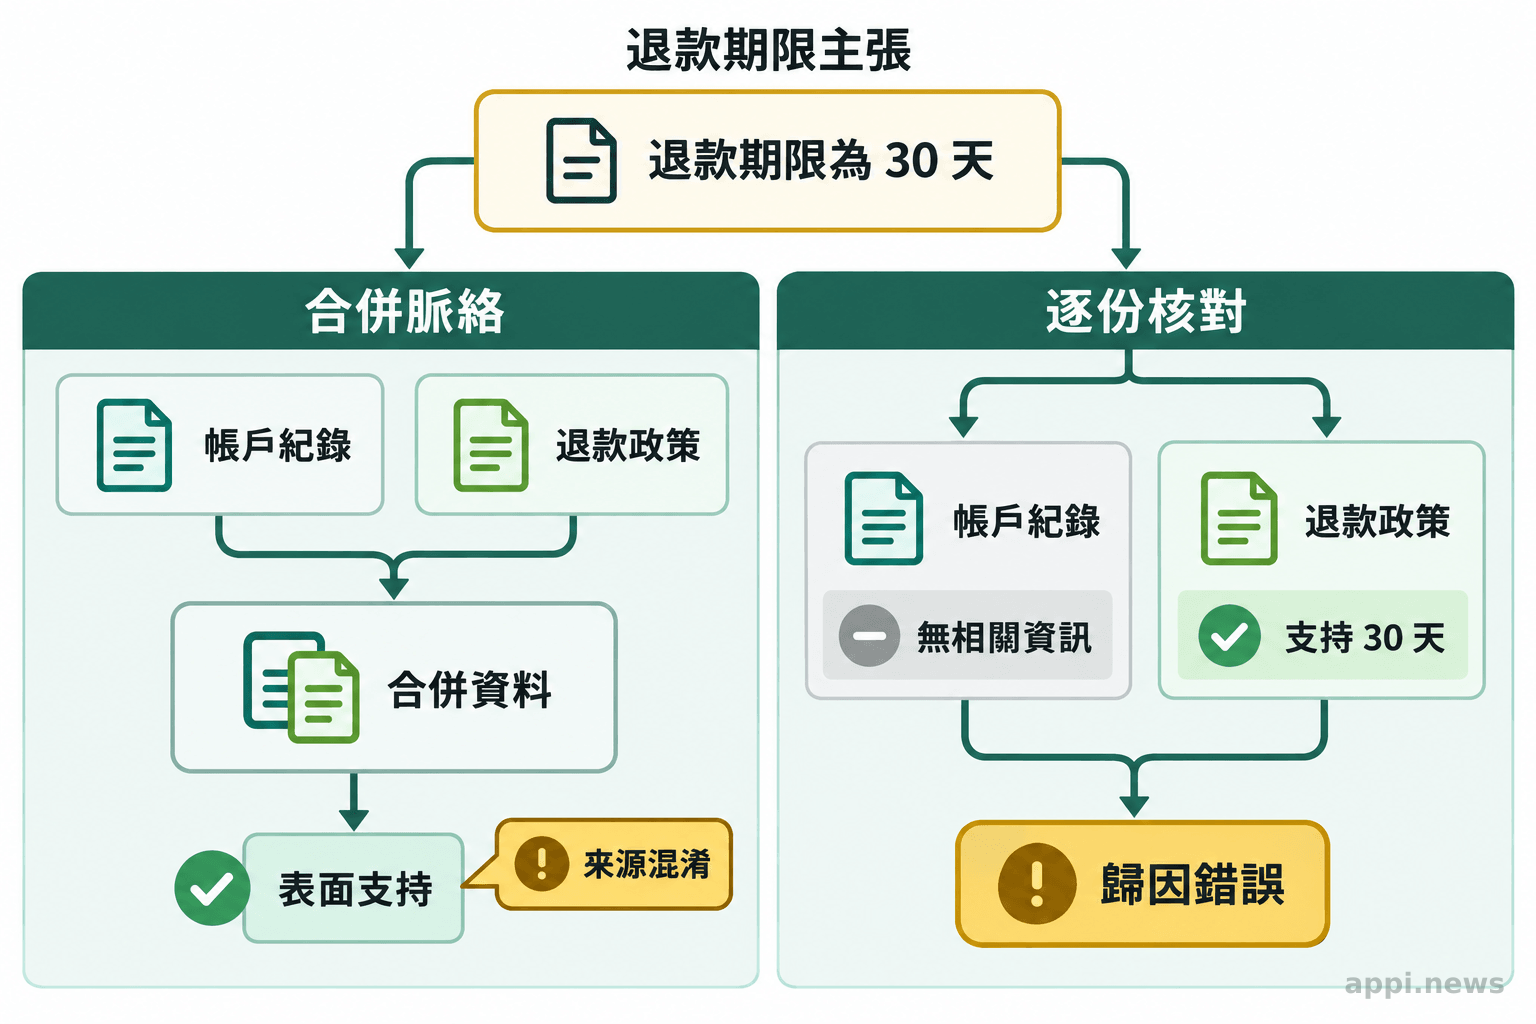
Ví dụ, một agent chăm sóc khách hàng đọc hồ sơ tài khoản và chính sách hoàn tiền rồi trả lời: “Theo hồ sơ tài khoản, gói này được hoàn tiền trong 30 ngày”. Thời hạn 30 ngày thật sự nằm trong chính sách, còn hồ sơ tài khoản không có thông tin đó. Câu trả lời vẫn chứa sự thật, nhưng người đọc bị dẫn đến sai tài liệu khi cần kiểm tra quyền hoàn tiền.
Vấn đề tương tự xuất hiện trong các agent xử lý dữ liệu nhạy cảm. Một chi tiết riêng của hồ sơ khách hàng mà câu trả lời lại trình bày như kết quả từ tài liệu nghiên cứu sẽ làm thay đổi ý nghĩa và trách nhiệm của thông tin. Tài liệu Ragas mô tả Faithfulness là cách kiểm tra mức độ các mệnh đề trong câu trả lời được hỗ trợ bởi ngữ cảnh cung cấp; khi ngữ cảnh đã bị gộp, điểm này chưa trả lời được câu hỏi nguồn nào thực sự hỗ trợ từng mệnh đề.
ProvenanceGuard kiểm tra câu trả lời theo từng nguồn
Hệ thống giữ mã công cụ và mã nguồn, tách câu trả lời thành các mệnh đề nguyên tử rồi kiểm tra riêng phần hỗ trợ và phần quy nguồn. Kết quả gồm phán định cho từng mệnh đề và quyết định cho toàn bộ câu trả lời: cho qua, chặn hoặc chuyển sang sửa.
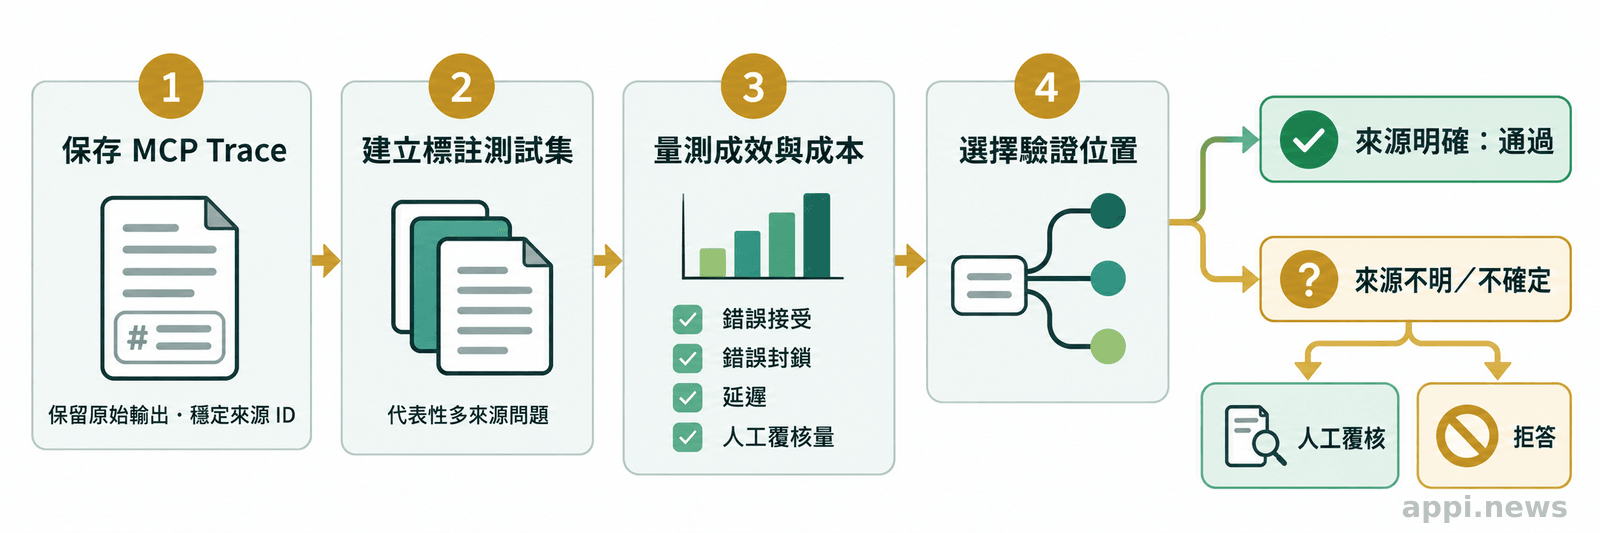
Bước đầu là lưu trace MCP, tức nhật ký yêu cầu, câu trả lời và đầu ra đầy đủ của các công cụ. Mỗi bằng chứng đi kèm loại công cụ, mã nguồn và nội dung quan sát được. Hai lần gọi cùng một công cụ nhưng lấy tài liệu khác nhau vẫn phải giữ mã riêng. Khi đầu ra không có mã nguồn ổn định, phương pháp lùi về tên công cụ làm định danh, khiến việc phân biệt các tài liệu trong cùng một công cụ kém chính xác hơn.
Sau đó, bộ phân tích tách câu trả lời thành các mệnh đề cần kiểm tra. Các giá trị làm thay đổi nghĩa như con số, đơn vị, ngày tháng và mã định danh được giữ nguyên. Bộ định tuyến tìm bằng chứng thuộc từng nguồn, mô hình suy luận ngôn ngữ tự nhiên đánh giá dữ liệu đang hỗ trợ, mâu thuẫn hay chưa đủ để kết luận, còn lớp đối chiếu nguồn kiểm tra xem mệnh đề có được gán cho đúng tài liệu hay không.
Với ví dụ hoàn tiền, hệ thống sẽ giữ hai mệnh đề riêng: thời hạn là 30 ngày và nguồn được nêu là hồ sơ tài khoản. Trace cho thấy chính sách hoàn tiền mới là nơi ghi thời hạn, nên phần hỗ trợ đúng nhưng phần quy nguồn bị chặn. Nếu chỉ lưu văn bản đã gộp, bộ kiểm tra không còn đủ dữ liệu để phát hiện sai lệch này.
Câu trả lời bị chặn được đưa qua quy trình sửa theo kiểu RARR rồi kiểm tra lại. Tuy vậy, lớp này chỉ kiểm tra quan hệ giữa mệnh đề và nguồn trong trace; nó không tự bảo đảm tài liệu gốc đúng, cũng không chứng minh mọi sự thật không được nêu đều chính xác.
Số liệu thử nghiệm nói được gì?
Bản thảo ProvenanceGuard trên arXiv mô tả 281 trace thực của một agent y tế và một tập con 266 trace có gán nhãn mệnh đề. Trong số đó, 361 nhãn của tập kiểm thử giữ lại được chuyên gia kiểm tra; phần huấn luyện và kiểm định không được tuyên bố có cùng mức kiểm tra thủ công.
Trong 361 mệnh đề của tập giữ lại, 139 mệnh đề cần bị chặn và 222 mệnh đề có nguồn hỗ trợ. Hệ thống đạt F1 chặn 0,802, độ chính xác 0,673 và độ bao phủ 0,993: 138 mệnh đề cần chặn bị chặn, một mệnh đề được cho qua; 155 mệnh đề có hỗ trợ được cho qua và 67 mệnh đề bị chặn nhầm. Những trường hợp bị chặn nhầm được đưa vào duyệt hoặc sửa, nhưng đó là cách vận hành chứ không phải một chỉ số hiệu năng riêng.
Trên 260 mệnh đề có nhãn nguồn, độ chính xác nguồn là 0,858. Ở một bài kiểm tra nhiều nguồn khó hơn, F1 chặn đạt 0,846 nhưng độ chính xác nguồn là 0,503; khi yêu cầu cả nguồn và quan hệ đều đúng, tỷ lệ còn 0,229. Hai bộ số liệu có câu hỏi, đơn vị tính và cách lấy mẫu khác nhau, nên không nên gộp thành một điểm “độ tin cậy”.
Nhóm nghiên cứu cũng thay nguồn được nêu trong 50 trường hợp kiểm soát nhưng giữ nguyên bằng chứng hỗ trợ; hệ thống phát hiện cả 50 lần tráo nguồn. Kết quả này cho thấy bộ kiểm tra nhận ra lỗi quy nguồn rõ ràng, không có nghĩa là nó luôn phân biệt được các tài liệu gần nghĩa trong hệ thống thật.
Những giới hạn quan trọng gồm dữ liệu đến từ một hệ thống agent y tế, nhãn được mô hình hỗ trợ tạo ra, kiểm tra thủ công tập trung ở dữ liệu giữ lại và các trường hợp gây nhiễu được kiểm soát. Tác giả nêu rõ phương pháp chưa giải quyết kiểm tra tính đúng đắn trong miền mở, kiểm tra an toàn theo lĩnh vực hoặc việc hiệu chỉnh kiến thức bên trong mô hình. Dùng trace y tế làm bối cảnh thử cũng không chứng minh công cụ đã được xác nhận cho quyết định lâm sàng.
- Đánh giá “có bằng chứng ở đâu đó” và “được nguồn được dẫn hỗ trợ” thành hai mục riêng.
- Đọc cùng F1 chặn, độ chính xác nguồn, tỷ lệ nguồn kèm quan hệ và số ca chặn nhầm cần người xử lý.
- Xem bản thảo arXiv là bằng chứng cho một thiết kế thử nghiệm, không phải tiêu chuẩn ngành hoặc cam kết hiệu quả dài hạn.
Chi phí tích hợp vào RAG và agent nằm ở đâu?
Chi phí đầu tiên là khả năng lưu trace; sau đó mới là mô hình kiểm tra, độ trễ và công việc của người duyệt. Hệ thống cũ chỉ giữ câu trả lời cuối hoặc ngữ cảnh đã gộp sẽ phải sửa định dạng log, chính sách lưu dữ liệu và cách gắn mã nguồn.
Đội ngũ cần kiểm tra trace có đủ lần gọi công cụ, đầu ra gốc, mã nguồn ổn định và nguồn được câu trả lời nêu hoặc ngụ ý hay không. Phải thử cả tài liệu có cấu trúc khác nhau, bảng, số liệu, cách viết tiếng Việt và các nguồn gần nghĩa. Nếu dữ liệu thiếu, hệ thống cần chuyển ca đó cho người duyệt hoặc trả lời thận trọng thay vì biến suy đoán thành kết luận.
Trong bài kiểm tra nhiều nguồn, thời gian kiểm tra trung bình theo nhóm câu hỏi là khoảng 0,189 giây trên gói mệnh đề đã được tách sẵn. Một lần chạy lại ở cấp câu trả lời, gồm tách theo quy tắc, sửa một lần và kiểm tra lại, mất khoảng 0,498 giây cho mỗi câu trả lời. Hai số đo có quy trình và đơn vị khác nhau; bài báo cũng không cung cấp đủ thông tin để xác nhận phần cứng giống nhau. Vì vậy, không nên dùng chúng làm cam kết thời gian đáp ứng cho hệ thống khác.
Trước khi tích hợp, nhóm vận hành nên lấy một tập câu hỏi nhiều nguồn trong thực tế, đánh dấu mệnh đề, nguồn đúng và cách quy nguồn chấp nhận được. Sau đó đo riêng thời gian kiểm tra, tỷ lệ bỏ sót, tỷ lệ chặn nhầm, số lần sửa, số lần người duyệt can thiệp và chi phí gọi mô hình. Vị trí triển khai thường là bước hậu kiểm RAG, cổng chặn trước khi gửi câu trả lời hoặc quy trình duyệt bắt buộc cho câu hỏi rủi ro cao.
Tại Việt Nam thì sao
Doanh nghiệp tại Việt Nam nên xem ProvenanceGuard là một lớp kiểm tra nguồn trong quy trình AI, không phải một gói phần mềm có mức giá chung cho mọi ngành. Chi phí thực tế phụ thuộc vào số người dùng, số lượt gọi mô hình, dữ liệu lưu trữ, máy chủ hoặc dịch vụ đám mây, phần kết nối với hệ thống cũ và thời gian của người duyệt. Khi hỏi nhà cung cấp, cần yêu cầu báo giá có thời hạn, đơn vị tính, phí lưu trữ trace, phí đưa dữ liệu ra ngoài và điều kiện thay đổi giá. Tính đến thời điểm bài viết được thực hiện, chúng tôi chưa tìm thấy bảng giá hoặc số liệu chính thức của cơ quan chức năng Việt Nam để so sánh chi phí triển khai AI giữa các ngành.
Quyết định 127/QĐ-TTg của Thủ tướng Chính phủ về chiến lược quốc gia nghiên cứu, phát triển và ứng dụng trí tuệ nhân tạo đến năm 2030 là điểm tra cứu chính sách chung về AI tại Việt Nam. Văn bản này không thay thế việc đánh giá một hệ thống cụ thể. Doanh nghiệp muốn tham gia chương trình hỗ trợ, đào tạo hoặc mua sắm cần đọc thông báo hiện hành của cơ quan chủ trì để xác định đối tượng, thời hạn và hồ sơ; không nên suy ra quyền hưởng hỗ trợ từ tên một công cụ.
Nghị định 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân là nguồn cần đưa vào bảng kiểm nếu trace chứa thông tin khách hàng, người lao động, bệnh nhân hoặc người dùng. Nhóm triển khai phải xác định dữ liệu nào được thu thập, mục đích xử lý, ai được truy cập, nhà cung cấp nào nhận dữ liệu, thời gian lưu và cách xử lý khi kết thúc hợp đồng. Nếu trace được dùng để huấn luyện, cải thiện dịch vụ hoặc chuyển cho bên khác xử lý, điều đó phải được làm rõ trong thiết kế và thỏa thuận liên quan.
Luật Công nghiệp công nghệ số số 71/2025/QH15 trên Cơ sở dữ liệu quốc gia về văn bản pháp luật là một nguồn cần đối chiếu khi hoạt động của doanh nghiệp thuộc phạm vi công nghiệp công nghệ số hoặc phát triển, cung cấp sản phẩm AI. Phạm vi áp dụng không nên được suy ra từ quảng cáo của nhà cung cấp. Đội pháp chế hoặc người phụ trách tuân thủ cần xem văn bản hiện hành, hợp đồng, loại dữ liệu và ngành sử dụng cùng nhau trước khi chốt kiến trúc.
Mức độ sẵn có của dịch vụ AI tại Việt Nam còn phụ thuộc kết nối, ngôn ngữ, khả năng tích hợp và chính sách lưu dữ liệu của từng nhà cung cấp. Một nhóm nên bắt đầu bằng bộ dữ liệu giả lập để kiểm tra việc tách mệnh đề và gắn nguồn trước khi đưa dữ liệu thật vào trace. Với chăm sóc khách hàng, nên giữ lại mã của hồ sơ đơn hàng và chính sách đổi trả để kiểm tra câu trả lời. Với tuyển dụng, cần ghi nguồn của từng tiêu chí và người duyệt đầu ra. Với sản xuất, log cần chỉ ra cảnh báo đến từ cảm biến, quy trình vận hành hay hướng dẫn bảo trì. Các ví dụ này là cách thiết kế ca kiểm thử; chúng không chứng minh mọi nhà cung cấp hay mọi ngành ở Việt Nam có cùng năng lực.
Trước khi mua, doanh nghiệp nên hỏi nhà cung cấp bảy điểm: trace có giữ đầu ra gốc không, mã nguồn có ổn định không, dữ liệu được lưu ở đâu, thời gian lưu là bao lâu, ai được xem log, khi nào câu trả lời bị chặn và người duyệt nhận được bằng chứng nào. Nếu chưa trả lời được các câu hỏi này, việc so sánh giá theo số lượt gọi sẽ bỏ sót chi phí kiểm soát, tích hợp và xử lý lỗi.
Đưa lớp kiểm tra vào quy trình hiện có
Nhóm kỹ thuật nên bắt đầu bằng một tập câu hỏi thật nhưng đã loại bỏ hoặc thay thế dữ liệu nhạy cảm. Mỗi câu trả lời được tách thành mệnh đề, gắn nguồn hỗ trợ, nguồn được nêu và kết quả chấp nhận. Tập này tạo đường cơ sở để so sánh bộ kiểm tra hiện tại với lớp kiểm tra có nhận biết nguồn.
- Giữ dấu vết: lưu yêu cầu, lần gọi công cụ, đầu ra gốc, mã nguồn, phiên bản và thời điểm.
- Tách mệnh đề: giữ nguyên số, ngày, đơn vị và mã định danh làm thay đổi ý nghĩa.
- Đo lỗi: tách tỷ lệ sai nguồn, thiếu hỗ trợ, bỏ sót và chặn nhầm.
- Chọn điểm chặn: đặt hậu kiểm sau RAG, cổng trước khi gửi hoặc bước duyệt cho nhóm rủi ro cao.
- Chuẩn bị đường lui: chuyển người duyệt hoặc trả lời không đủ dữ liệu khi nguồn không rõ.
Kiểm tra nguồn là một cổng, không phải lời bảo đảm
ProvenanceGuard làm rõ một lỗi mà điểm số hỗ trợ tổng thể dễ bỏ qua: câu trả lời đúng ở nội dung nhưng sai ở nguồn được dẫn. Thiết kế giữ mã nguồn trong trace, tách mệnh đề và kiểm tra quy nguồn giúp người duyệt nhìn thấy lý do cho từng quyết định.
Nhưng lớp kiểm tra vẫn phụ thuộc chất lượng trace, dữ liệu thử, mô hình định tuyến và quy tắc xử lý ca không chắc chắn. Tại Việt Nam, việc đưa hệ thống vào vận hành còn phải đặt cạnh yêu cầu về dữ liệu, hợp đồng, ngành sử dụng và trách nhiệm nội bộ. Kết quả thử nghiệm nên được dùng để thiết kế bài kiểm tra tiếp theo, không phải để bỏ qua các bước đó.
Câu hỏi thường gặp
ProvenanceGuard khác gì điểm Faithfulness của RAG?
Faithfulness thường hỏi mệnh đề có được ngữ cảnh cung cấp hỗ trợ hay không. ProvenanceGuard giữ nguồn riêng của từng đầu ra để hỏi thêm nguồn được câu trả lời nêu có phải là nguồn hỗ trợ hay không.
Trace không có mã nguồn thì còn kiểm tra được không?
Hệ thống vẫn kiểm tra ở mức thô hơn bằng tên công cụ, nhưng nếu một công cụ trả về nhiều tài liệu thì việc quy nguồn sẽ khó chính xác. Hệ thống nên bổ sung mã nguồn ổn định và đặt đường chuyển duyệt cho ca không thể xác định.
Nghiên cứu đã chứng minh phương pháp phù hợp với y tế chưa?
Chưa. Nghiên cứu dùng trace của agent y tế làm bối cảnh thử, không phải đánh giá can thiệp lâm sàng hay thiết bị y tế. Các đội ngũ phải kiểm tra lại trên dữ liệu đại diện cho ngành và quy trình của mình.
Bước đầu tiên trước khi tích hợp là gì?
Chọn một tập câu hỏi nhiều nguồn, đánh dấu từng mệnh đề và nguồn chấp nhận được, rồi đo lỗi bỏ sót, chặn nhầm, độ trễ và thời gian người duyệt. Sau đó mới chọn vị trí đặt cổng kiểm tra.
Nguồn và tài liệu tham khảo
- Alvarez A và cộng sự (2026), ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents (bản thảo tiếng Anh)(arXiv)
- Tiene A, Alvarez A, Wirjadi O (2026), Getting the Source Right, Not Just the Fact: Source-Aware Verification for MCP Agents (tiếng Anh)(Hugging Face Blog)
- Faithfulness (tiếng Anh)(Ragas Documentation)
- Quyết định 127/QĐ-TTg về chiến lược quốc gia nghiên cứu, phát triển và ứng dụng trí tuệ nhân tạo đến năm 2030(Cổng thông tin điện tử Chính phủ Việt Nam)
- Nghị định 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân(Cổng thông tin điện tử Chính phủ Việt Nam)
- Luật Công nghiệp công nghệ số số 71/2025/QH15(Cơ sở dữ liệu quốc gia về văn bản pháp luật)


